

Atalaya, el sistema de métricas y logs que he construido sobre ClickHouse para mi homelab, ya de código abierto: el modelo de datos de Cloud Monitoring, todas las métricas para siempre en niveles con percentiles que no se pierden, logs para siempre, 4,6 veces menos bytes por punto que el esquema de OpenTelemetry y la mitad de disco que la pila a la que sustituye.
Mi homelab funciona sobre tres servidores con Nomad: Thor, Odin y Freya. Vigilarlas me costaba cinco piezas: vmagent y VictoriaMetrics para las métricas, vector y VictoriaLogs para los logs, y Grafana encima. Los logs se borraban a las cuatro semanas. Las métricas se guardaban a resolución completa hasta que el disco dijera basta.
El plan era una migración de manual a ClickStack, el paquete de OpenTelemetry de ClickHouse. Entonces pedí una sola cosa: guardarlo todo, para siempre. Los logs de por vida y las métricas compactadas a medida que envejecen, como las guarda Google Cloud Monitoring. Esa petición cambió el diseño, y el resultado es Atalaya: un collector y un servidor en Rust sobre ClickHouse, con el modelo de datos de Cloud Monitoring. Ahora es de código abierto, con licencia Apache 2.0: github.com/mariojcr/atalaya.
La versión corta:
- Un collector, un servidor y ClickHouse sustituyen a vmagent, VictoriaMetrics, vector, VictoriaLogs y Grafana.
- Todas las métricas para siempre: en crudo 7 días, a 1 minuto 6 semanas y a 10 minutos sin fecha de caducidad, con percentiles que sobreviven a la reducción (un p99 diario a un 0,7 % del exacto).
- Logs para siempre también, con índice de texto, a 36 bytes por línea.
- 0,76 bytes por punto, 4,6 veces menos que el esquema de OpenTelemetry en el mismo ClickHouse.
- 4,5 GiB para todo, con ocho meses de historial importado, frente a 9 GiB de la pila antigua.
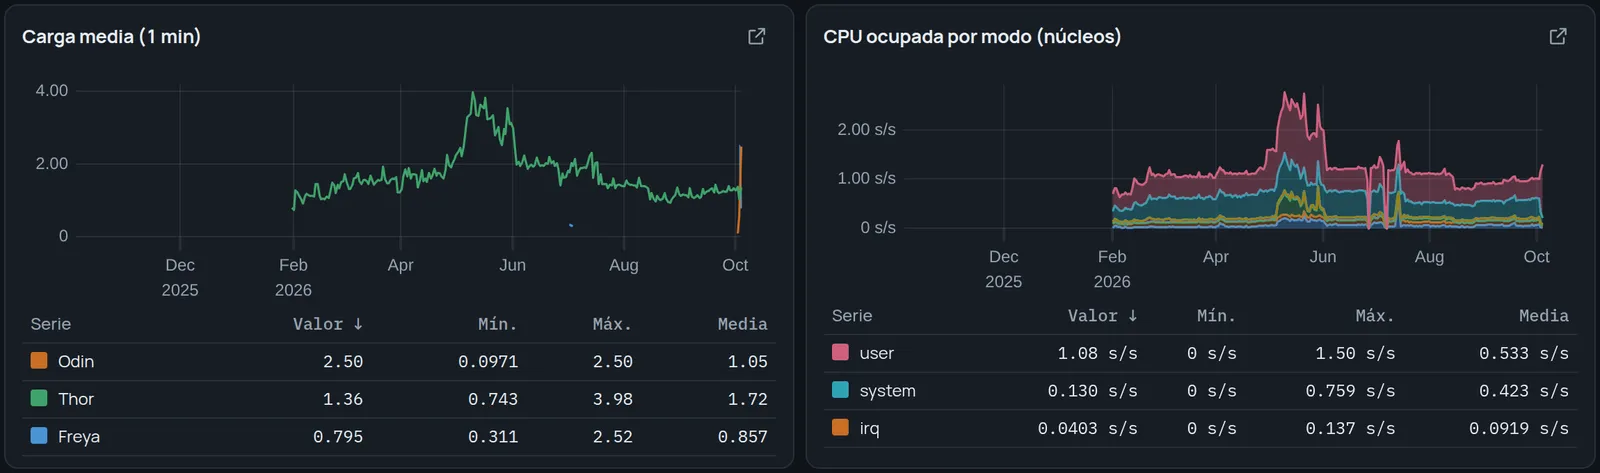
- Las 452 consultas de mis paneles de Grafana funcionan sin cambios con su propio motor de PromQL, y un año de CPU por modo se dibuja en 0,6 s.
- De código abierto: dos imágenes de contenedor y un ejemplo de Docker Compose que lo levanta todo en una sola máquina.
Por qué no meter OpenTelemetry en ClickHouse y ya
ClickStack era el camino evidente, así que lo medí primero, con mis propios datos. El esquema de métricas de OpenTelemetry escribe cada punto junto a sus mapas de atributos: los del recurso, los de la métrica y el scope. ClickHouse los comprime bien, pero son los mismos mapas en cada fila de una serie, millones de veces.
3,47 bytes por punto, 2,7 de ellos en mapas repetidos. Cargar 17 millones de muestras provocó fusiones de hasta 5,7 GiB, tardó más de 10 minutos y se quedó sin memoria tres veces. Las mismas muestras con el esquema de Atalaya: 14 segundos y unos 250 MB.
El modelo de Cloud Monitoring, en cuatro tablas
Cloud Monitoring, y Monarch, el sistema que tiene detrás, describen una métrica una vez, una serie temporal una vez, y después solo guardan puntos. Atalaya hace lo mismo:
- Descriptores de métrica: una fila por métrica, con su tipo (gauge, acumulada, delta o distribución), su unidad y su descripción.
- Series: una fila por serie temporal, identificada por un hash de 64 bits (xxh3) de su métrica y sus etiquetas. Las etiquetas viven aquí, una sola vez.
- Puntos: serie, tiempo, valor. Nada más.
- Logs, con el job, la tarea y el alloc de Nomad de cada línea.
El collector descubre los objetivos a través de Nomad, registra cada serie la primera vez que la ve y a partir de ahí solo envía puntos. La tabla de puntos es casi nada:
CREATE TABLE atalaya.points
(
    Metric   LowCardinality(String),
    SeriesId UInt64,
    Time     DateTime CODEC(DoubleDelta, ZSTD(1)),
    Value    Float64  CODEC(Gorilla, ZSTD(1)),
    Counter  Bool DEFAULT false
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(Time)
ORDER BY (Metric, SeriesId, Time)
TTL Time + INTERVAL 7 DAY;
Con las filas ordenadas por serie y luego por tiempo, DoubleDelta convierte las marcas de tiempo regulares en rachas de ceros y Gorilla guarda cada valor como el XOR con el anterior. En producción, la tabla de puntos crudos está en 0,67 bytes por punto.
Para ser justos con VictoriaMetrics: por muestra cruda es más compacto, con 0,24 bytes. Atalaya no gana comprimiendo. Gana porque no guarda cada muestra para siempre.
Más grueso con la edad, escrito al insertar
Cada inserción en points alimenta además dos vistas materializadas, que agregan en una tabla de 1 minuto y otra de 10 minutos. Cada fila de un nivel guarda el mínimo, el máximo, la suma y el número de muestras de su tramo, la hora de su última muestra y un sketch para los percentiles:
CREATE MATERIALIZED VIEW atalaya.points_10m_mv TO atalaya.points_10m AS
SELECT Metric, SeriesId, toStartOfInterval(T0, INTERVAL 10 MINUTE) AS Time,
       min(Value) AS Min, max(Value) AS Max, sum(Value) AS Sum, count() AS Count,
       max(T0) AS LastTime,
       quantilesDDStateIf(0.01, 0.5, 0.95, 0.99)(Value, NOT Counter) AS Sketch
FROM (SELECT Metric, SeriesId, Time AS T0, Value, Counter FROM atalaya.points)
GROUP BY Metric, SeriesId, Time;
ClickHouse también puede agregar las filas cuando caducan, con TTL … GROUP BY. Lo probé y lo descarté: agrega durante las fusiones, con los grupos en memoria, y en una máquina de homelab era la opción que más memoria pedía. Las vistas cuestan un poco más en cada escritura y nunca dan sorpresas.
Dos detalles importan más de lo que parece:
- Los contadores guardan su máximo, no su media. Una tasa sobre un nivel sale del máximo de cada tramo, y
LastTimedice cuándo se leyó ese máximo, así que un tramo a medias (un reinicio, un hueco) no se convierte en un pico. - Los histogramas de Prometheus son distribuciones. Sus cubos acumulados se guardan tal cual llegan; los percentiles de cualquier ventana salen de la diferencia entre los cubos al final y al principio, en cualquier nivel.
Percentiles que sobreviven a la reducción
El error clásico al reducir resolución es guardar el p99 de cada tramo y promediarlos después. El p99 de un día no es la media de 144 p99 de diez minutos, y el error es mayor justo cuando ha pasado algo.
Un sketch, en cambio, se puede combinar. DDSketch reparte los valores en cubos logarítmicos con un error relativo acotado (aquí del 1 %, el primer parámetro de quantilesDD), y 144 sketches de diez minutos se combinan en el sketch del día. Medido: un p99 diario calculado desde los sketches de 10 minutos quedó a un 0,7 % del p99 exacto sobre los puntos crudos. Eso es lo que permite que el nivel de 10 minutos viva para siempre y siga dando el p99 correcto de cualquier día, meses después.
Logs, para siempre
CREATE TABLE atalaya.logs
(
    Time       DateTime64(3) CODEC(Delta(8), ZSTD(1)),
    Service    LowCardinality(String),
    Host       LowCardinality(String),
    Stream     LowCardinality(String),
    Level      LowCardinality(String),
    Body       String CODEC(ZSTD(3)),
    Resource   Map(LowCardinality(String), String) CODEC(ZSTD(1)),
    Attributes Map(LowCardinality(String), String) CODEC(ZSTD(1)),
    INDEX idx_body lower(Body) TYPE text(tokenizer = 'splitByNonAlpha'),
    INDEX idx_level Level TYPE set(16) GRANULARITY 4
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(Time)
ORDER BY (Service, Time);
Sin TTL, y con particiones mensuales para que su número siga siendo pequeño con los años. El índice de texto de ClickHouse hace que una búsqueda por palabra se salte bloques enteros en vez de recorrerlos. 36 bytes por línea, índice incluido.
Traer el historial de logs era lo urgente: VictoriaLogs guardaba cuatro semanas, y cuando arrancó la importación ya había borrado todo lo anterior al 5 de septiembre. Las 1,32 millones de líneas que quedaban ya no caducan.
Traerse ocho meses de historial
VictoriaMetrics tenía 36.600 millones de muestras desde febrero, en 8,3 GiB. Reinsertarlas en crudo no tenía sentido, porque los puntos crudos solo viven una semana. La importación pasa por tablas Null: ClickHouse no guarda nada en ellas, y sus vistas materializadas escriben directamente en los niveles. Lo de las últimas seis semanas cae en los dos niveles; lo anterior, solo en el de 10 minutos.
La lectura la hace el propio ClickHouse: su función de tabla url() trae cada día de la API de exportación de VictoriaMetrics, así que las muestras no pasan por ningún script. Cuatro workers, un día cada vez, tardaron unas 12 horas. La importación se saltó las métricas de las herramientas que se retiraban, unas 10.000 de 23.000 series, porque nadie necesita el historial del propio Grafana cuando Grafana ya no está.
Ahí mismo apareció uno de esos fallos de los que nadie avisa: retirar Grafana en mitad de la importación cortó uno de los workers. El firewall de VictoriaMetrics tenía una regla para el servicio de Grafana; al desaparecer el servicio, el sidecar del firewall se reinició y tiró la conexión del worker que iba por la mitad del 29 de junio. Borrar las filas a medias de ese día y relanzar el worker desde él lo arregló. Los otros tres ni se enteraron.
Dónde están los bytes, por fila:
| Tabla | Qué guarda una fila | Bytes por fila |
|---|---|---|
points | una muestra, 7 días | 0,67 |
points_1m | un minuto: mínimo, máximo, suma, número, sketch | 3,5 |
points_10m | diez minutos, los mismos campos | 7,4 |
logs | una línea, con su índice de texto | 36 |
4,5 GiB en disco para todo, unas 23 veces menos que los mismos datos sin comprimir.
Habla PromQL, así que los paneles se vinieron
El explorador propio de Atalaya funciona como el de Cloud Monitoring: alineadores y reductores, consultas A, B y C con fórmulas, comparación con un periodo anterior. Pero mis ocho paneles de Grafana estaban escritos en PromQL, así que Atalaya implementa también la API HTTP de Prometheus con su propio motor de PromQL en Rust, evaluado sobre los niveles.
Las 452 consultas de esos paneles funcionan sin errores. Frente a VictoriaMetrics, los gauges e irate salen idénticos. rate difiere hasta un 12 % en ventanas de 5 minutos y un 2 % en una hora, porque los dos motores extrapolan de forma distinta los bordes de la ventana.
Otro fallo de los que nadie avisa: tras la migración, el indicador «CPU Busy» marcaba un 21–55 % con la máquina al 3 %. El collector envía cada 30 segundos y el panel pedía datos hasta «ahora», así que la última ventana de 60 segundos tenía dos muestras y la tasa se extrapolaba desde media ventana. Prometheus tiene el mismo problema, y el arreglo es el de Grafana: los rangos relativos terminan 45 segundos atrás. Ahora el indicador marca un 3,5 %.
Hacerlo rápido: el 94 % era leer
Antes de optimizar nada, medí dentro del servidor. Del tiempo de una consulta típica de un panel, el 94 % era leer muestras de ClickHouse; evaluar el PromQL tardaba 0–3 ms. Y ClickHouse leía entre 27 y 67 veces más filas de las que devolvía: su índice trabaja en bloques de 8.192 filas, y una serie tiene unos 1.440 puntos al día, así que cada serie arrastraba casi un bloque entero.
Tres cambios:
- Reducir dentro de ClickHouse, al paso de la gráfica, como hace Cloud Monitoring con su periodo de alineación. Una gráfica de un año dibuja unos cientos de puntos por serie; no necesita las 52.000 filas de 10 minutos que tiene cada serie en un año.
- Bloques de índice más pequeños, de 512 a 2.048 filas en vez de 8.192. No se puede cambiar en caliente, así que cada tabla se reconstruyó y se intercambió de forma atómica. Una consulta de una hora pasó de leer 84.806 filas a 21.504.
- Menos por la red: RowBinary en vez de TSV entre ClickHouse y el servidor, respuestas comprimidas (la lista de métricas pasó de 465 a 47 KB, una hora de logs de 228 a 9 KB) y los paneles agrupados en una sola petición en vez de una cada uno.
Agregar dentro de ClickHouse fue lo que más ayudó en rangos largos: un año de CPU por modo pasó de 5,5 a 0,6 segundos, con el servidor por debajo de 100 MB. El panel completo de Node Exporter, 276 consultas, carga ahora en 2,9 segundos con una mediana de 30 ms por consulta; VictoriaMetrics respondía ese tipo de consulta en unos 20 ms dentro de su propio servidor, así que están en la misma liga. El conjunto de paneles, casi todo rangos cortos, mejoró menos con el resto, un 23 %, y los bloques de índice más pequeños ayudaron menos de lo que esperaba: el peso de verdad estaba en las filas de los niveles aún sin fusionar. Cada envío de 30 segundos escribe su propia fila parcial para el mismo minuto, dos por minuto, hasta que ClickHouse las fusiona, y mientras tanto una consulta tiene que leer y combinar las dos.
Lo que cuesta tenerlo en marcha
El collector es la parte barata: 20–30 MB de memoria y un 0,1–0,17 % de un núcleo en cada nodo, con su raspado más largo en 150 ms. Guarda en disco lo que no puede enviar cuando ClickHouse no está, y sobrevivió a un reinicio de ClickHouse sin perder un lote.
Lo caro era un ajuste. Con lotes de 10 segundos, cada envío creaba una parte en cada tabla y nivel: unas 90 partes nuevas por minuto que ClickHouse tenía que fusionar. Pasar a lotes de 30 segundos, volcar los logs internos de ClickHouse una vez por minuto en vez de cada 7,5 segundos y ajustar las reservas al uso real dejó a Atalaya reservando 1.020 MHz de CPU frente a los 1.690 de la pila antigua.
Frente a lo que sustituye, medido en una hora limpia:
- Disco, memoria y reservas bajan: la mitad de disco, un 29 % menos de memoria residente (casi toda caché de ClickHouse) y menos de la mitad de memoria reservada en Nomad.
- También ingiere menos: 791 puntos por segundo frente a 1.880 muestras, porque la pila antigua raspaba cada 10 segundos y además se raspaba a sí misma.
- La escritura a disco es donde gana la pila antigua: 34 KB/s frente a los 171 de ClickHouse. ClickHouse alimenta dos niveles más y fusiona partes; el cambio de lotes ya la había bajado desde 545 KB/s, con un 58 % menos de partes y un 70 % menos de fusiones. En un NVMe no importa.
Hay un coste de escritura que una hora puede no ver: para borrar las filas caducadas, ClickHouse reescribe la partición mensual, cada 4 horas por defecto. Entre las cuatro tablas con TTL eran 33 GiB escritos al día. Con una vez al día basta (merge_with_ttl_timeout = 86400); lo caducado simplemente dura hasta un día más.
La interfaz es la estructura, no la paleta
La primera interfaz copiaba la de Cloud Monitoring, y funcionaba. Cuando pedí algo más atractivo, la primera ronda de diseños llegó con seis direcciones que eran un mismo diseño en seis paletas: la misma barra lateral, la misma fila de indicadores, la misma rejilla de tarjetas con gráficas. Una interfaz la define su esqueleto; cambiarle los colores por encima no la convierte en otro diseño.
La segunda ronda varió la estructura, y cada dirección resultó responder a una pregunta distinta:
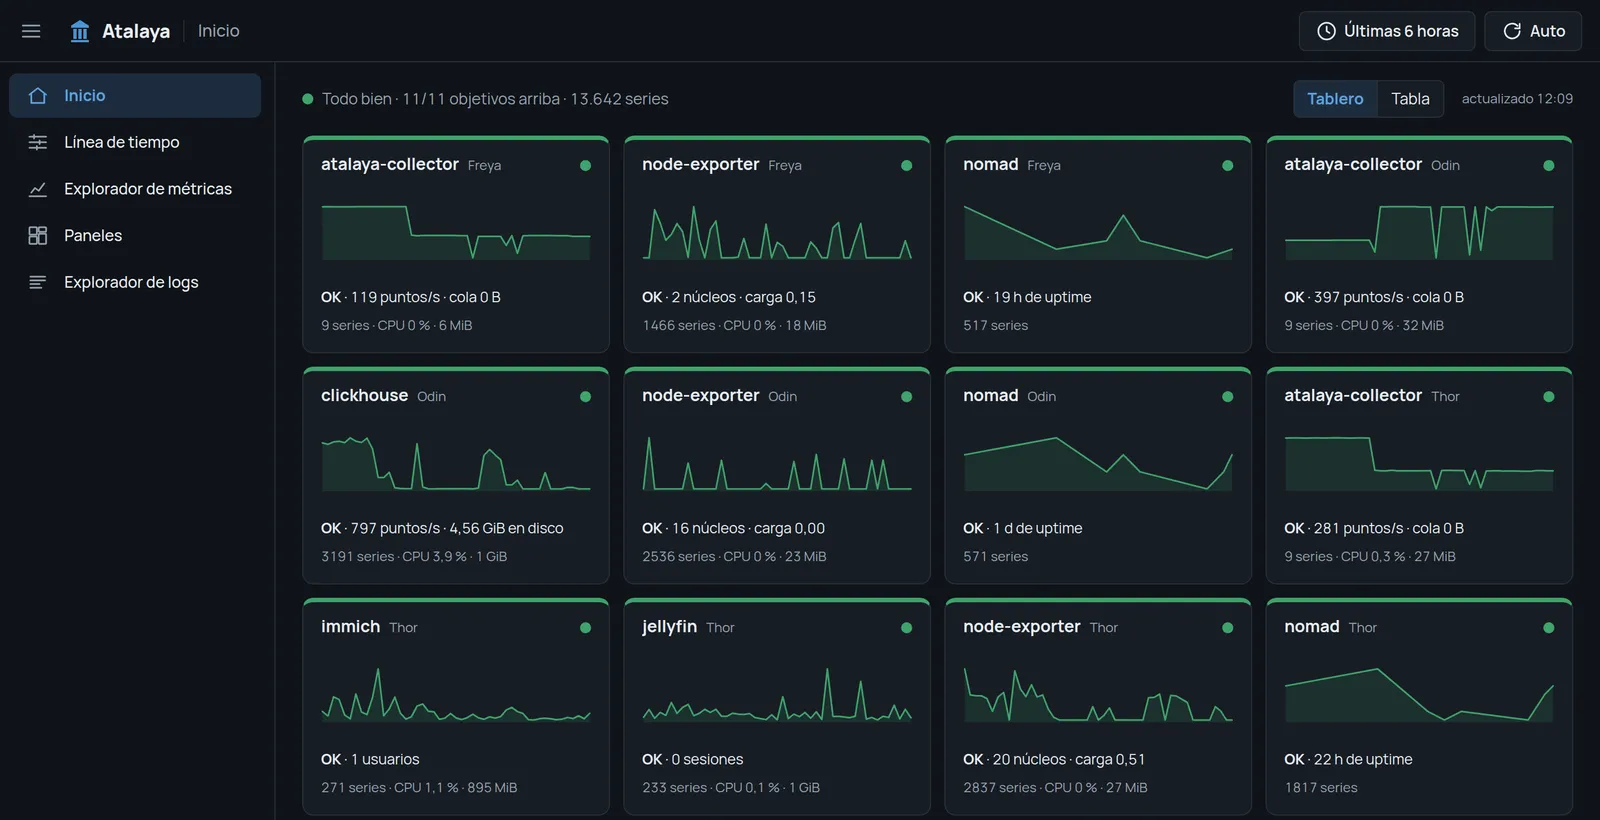
- ¿Cómo está todo ahora? Un tablero de estado con una tarjeta por servicio, una tabla densa con una fila por host y servicio, y un mapa del homelab.
- ¿Qué pasó? Una línea de tiempo: un solo eje de tiempo y carriles debajo para despliegues y reinicios, ráfagas de logs por servicio, alertas y unas pocas métricas clave.
- ¿Por qué? Un cuaderno, donde una investigación es texto, consultas y gráficas en celdas.
Así que son un solo producto, no seis alternativas. El tablero y la tabla son la portada, dos densidades del mismo «ahora»; la línea de tiempo es donde empieza una investigación, y el cuaderno, donde se escribe.
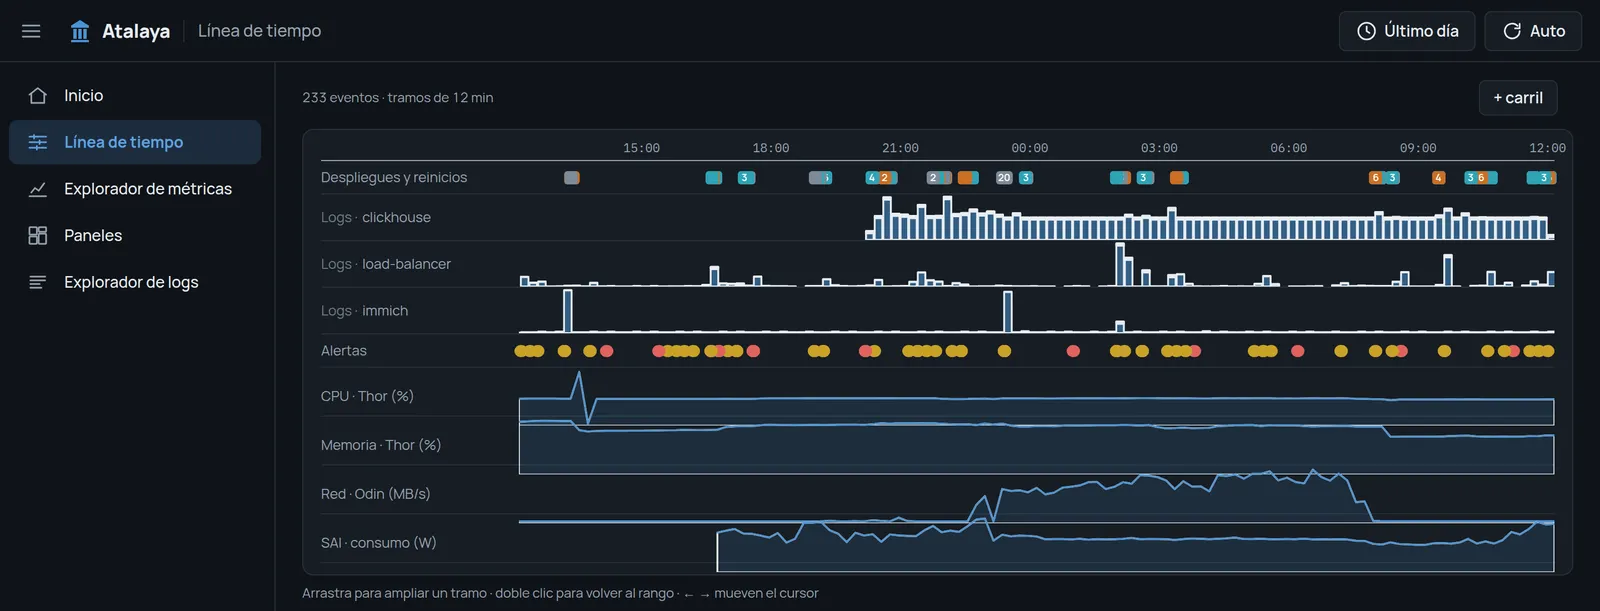
La línea de tiempo saca sus eventos de Nomad y de los logs, y los agrupa: un despliegue del collector en los tres nodos aparece como dos eventos, «3 allocs nuevas» y «3 paradas», no uno por línea. Agruparlos dejó un día en 220 eventos en vez de 371.
Lo que me quedo de esto
- Mide el esquema con tus datos antes de adoptarlo. El de OpenTelemetry es un buen formato de intercambio; como formato de almacenamiento de métricas costaba 4,6 veces más por punto.
- Reduce al insertar y guarda sketches, no percentiles. Las medias de p99 mienten; los sketches combinados, no.
- Averigua a dónde va el tiempo antes de optimizar. El motor de PromQL era el objetivo tentador, y suponía 0–3 ms de cada consulta.
- En ClickHouse, el tamaño del lote es un coste. Cada inserción es una parte, y cada parte, una fusión.
- Si no necesitas «para siempre», VictoriaMetrics es difícil de batir. Ocupa menos por muestra cruda, escribe menos a disco y no tienes que escribirlo tú.
Pruébalo
Atalaya está en GitHub con licencia Apache 2.0: github.com/mariojcr/atalaya. Cada versión publica dos imágenes, ghcr.io/mariojcr/atalaya-server y ghcr.io/mariojcr/atalaya-collector, y el repositorio trae un ejemplo de Docker Compose que levanta ClickHouse, el esquema, el servidor, un collector y node-exporter en una sola máquina, con paneles y reglas de alerta de ejemplo:
git clone https://github.com/mariojcr/atalaya
cd atalaya/examples/compose
for u in ADMIN READER COLLECTOR; do echo "CLICKHOUSE_${u}_PASSWORD=$(openssl rand -hex 16)"; done > .env
docker compose up -d
La interfaz queda en http://localhost:8080. No hace falta Nomad: sin él, el collector raspa destinos estáticos y lee los logs de Docker. También lee el hardware de la máquina (temperaturas, ventiladores, energía de la CPU, GPU, salud SMART de los discos), y el servidor evalúa reglas de alerta con silencios y las envía a ntfy, Telegram o un webhook. El repositorio trae también un ejemplo para un clúster de Nomad.
Es la versión 0.1.0 y vigila mi homelab todos los días. El motor de PromQL cubre lo que suelen usar los paneles, no el lenguaje entero, y el inicio de sesión (OpenID Connect) es opcional, así que sin él conviene dejar el servidor en una red privada o detrás de un proxy que autentique.
Lo siguiente: el mapa del homelab y un catálogo de métricas. Las reglas del collector ya permiten quedarse con unas métricas, descartar otras y agregarlas por servicio; aplicar un catálogo con solo lo que usan los paneles y las alertas bajaría de 13.844 series a unas 1.400. Los avisos de fallos y los pull requests son bienvenidos.