

mnemo es la memoria a largo plazo que he construido para Claude Code, Codex y mis propios agentes: recuerdos de seis W destilados en segundo plano, un juez que cierra lo que deja de ser verdad, búsquedas en 35–50 ms sin llamar a ningún modelo y una forma de medir si lo que añade al contexto se usa. En una comparativa dentro de Claude Code acertó las 18 preguntas y fue la que menos gastó por acierto.
Cada sesión de Claude Code o de Codex empieza de cero. Vuelves a explicar en qué estás, qué decidiste ayer y por qué, o lo dejas escrito en un AGENTS.md que engorda cada semana y se queda viejo antes de lo que te gustaría. Y las memorias para agentes que hay por ahí se van al otro extremo: guardan muchísimo y nunca te dicen si algo de eso sirve.
Así que me hice la mía: mnemo, una sola memoria para Claude Code, Codex y mis propios agentes, que guarda el porqué de las cosas, cierra lo que deja de ser verdad y mide si lo que añade al contexto se usa. Es un binario en Rust sobre ClickHouse, de código abierto (Apache 2.0) y publicado en GitHub. De la idea a la primera versión pasaron dos semanas.
En resumen:
- 18 de 18 en una comparativa con mem0, Graphiti, memvid y la memoria propia de Claude Code, hecha dentro de sesiones reales de Claude Code. Y fue la que menos gastó: 134.000 tokens por acierto, por los 223.000 de mem0 y los 241.000 sin memoria.
- Recuerdos de seis W (qué, quién, cuándo, dónde, por qué y cómo), que un modelo saca de las conversaciones en segundo plano y que se enlazan por las entidades que comparten.
- Un juez que cierra lo que deja de ser verdad sin borrarlo, y una regla determinista que le impide fusionar «120 s» con «600 s».
- Búsquedas sin LLM: un índice en RAM responde en 35–50 ms, contando el embedding de la pregunta.
- Mide si sirve: cada recuerdo que añade se contrasta con la respuesta, y el que nunca se usa deja de añadirse. En 30 días, la memoria fue el 0,007 % de lo que leyeron mis sesiones.
Medir antes de seguir
Antes de ir más lejos quería decidir midiendo, no leyendo READMEs. Para eso monté en una tarde memarena, un banco de pruebas que pone a cada sistema de memoria a trabajar en sesiones reales de Claude Code:
- El mismo escenario para todos: ocho sesiones de trabajo sobre un repo real y grande al que le quité la documentación, y después seis preguntas por ronda. Dos solo se pueden contestar recordando una sesión anterior: el nombre en clave del entorno de pruebas y el día de despliegue, que cambia a mitad del escenario. Otras tres se pueden volver a sacar del código, y la última es sobre algo dicho antes en la misma sesión, después de compactarla.
- Las mismas condiciones: los mismos hooks (recuperación al abrir la sesión y antes de cada mensaje, hasta 900 tokens), las mismas dos herramientas MCP, y el mismo modelo para el trabajo en segundo plano y el mismo embedder. Antes de cada sesión, el banco espera a que todos hayan vaciado su cola.
- Lo que se mide: si la respuesta es correcta, según un juez LLM que la compara con la verdad («no lo sé» cuenta como fallo), y cuántos tokens cuesta cada acierto, sumando la sesión y lo que gasta la memoria por detrás.
Las que marcan la diferencia son las dos preguntas de memoria; el resto lo acaban sacando casi todos leyendo el código, unos gastando más y otros menos. El día de despliegue es la que mejor lo enseña: es el martes en la sesión 2 y pasa al jueves en la 6. mnemo y memvid contestaron «jueves» las tres veces, mem0 una y Graphiti ninguna. Lo de mnemo no fue suerte: su juez había cerrado el recuerdo del martes en cuanto llegó el del jueves.
Que sea la más barata se explica igual. Sin memoria, el agente vuelve a buscar en el código lo que ya sabía, y cada búsqueda son tokens: en las sesiones de preguntas hizo 23 llamadas a herramientas por ronda sin memoria y 9 con mnemo.
Conviene tomarlo con pinzas. El escenario lo escribí yo, que además soy el autor de uno de los participantes. La muestra es pequeña: un solo escenario, con dos preguntas que de verdad separan. mem0 no registró actividad en dos de las tres rondas, así que parte de su resultado puede ser culpa de mi adaptador. Y la documentación que quité seguía en el historial de git, donde algún participante la encontró. Me falta pasar LoCoMo, un banco público de memoria conversacional. Aun así, como señal me bastó para seguir con mnemo.
Episodios y recuerdos de seis W
Todo lo que llega a mnemo es un episodio: un prompt, una respuesta final, el resultado de una herramienta, el paso de un flujo. No se modifica ni se tira nunca, y guarda quién lo dijo, dónde y cuándo. Si los recuerdos no bastan, la búsqueda baja a los episodios.
Cuando una conversación lleva dos minutos parada, un modelo la lee y saca recuerdos de seis tipos: hechos, eventos, estados (cosas ciertas ahora pero pasajeras, como una caída), decisiones, preferencias y procedimientos. Cada recuerdo responde a las seis W, enlaza las entidades que intervienen con el papel de cada una y cita los episodios de los que sale:
Qué: se subió el timeout del gateway a 600 s. Por qué: el balanceador cortaba los streams a los 120 s. Cómo: con
timeout_secenlb.tf. Quién: Ana. Dónde: el gateway y el repo de infraestructura.
El prompt de extracción es muy estricto con lo que más daño hace:
- Solo lo que le sirva a otra conversación más adelante. Nada de «los tests están en verde» ni de diarios de trabajo.
- El porqué y el cómo, solo si aparecen en la conversación. Nunca se inventan.
- Una propuesta no es una decisión hasta que una persona la acepta. Y eso no se deja solo en manos del modelo: si ninguna línea escrita por una persona respalda una decisión, se guarda como un hecho.
Los recuerdos se guardan en inglés, porque quien los lee es un modelo, pero se pueden consultar en cualquier idioma. Con las mismas 12 preguntas en inglés y en español, el recuerdo correcto salió el primero 9 y 8 veces, y entre los tres primeros, 11 y 10.
Para destilar uso Qwen3.6-35B-A3B. Probé modelos pequeños, para que pudiera funcionar en cualquier máquina, y no dieron la talla: uno de 4B se metía en bucles repitiendo entidades, y otro devolvía siempre un JSON bien cerrado, pero con todos los porqués y cómos vacíos y con los consejos del asistente guardados como decisiones.
Un juez que cierra lo que deja de ser verdad
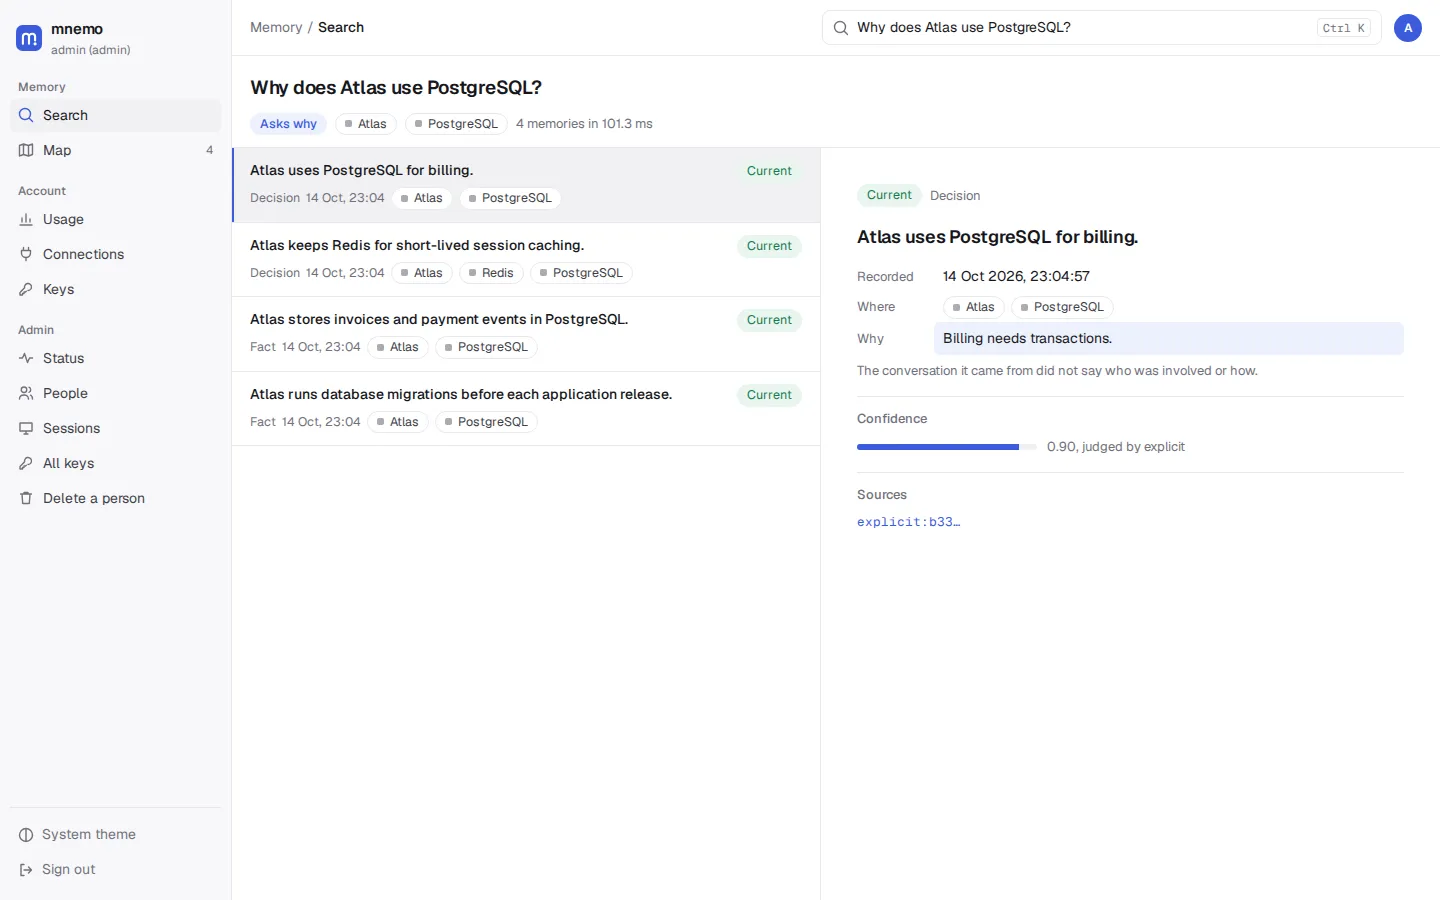
Cada recuerdo nuevo se compara con hasta ocho recuerdos vigentes cercanos: los tres más parecidos por vector, tres por texto y el resto por entidades en común. Un modelo de decisiones, que no escribe texto libre sino que responde preguntas cerradas con probabilidades calibradas, dice para cada uno si el nuevo es el mismo recuerdo, si lo actualiza, si lo contradice o si habla de otra cosa. Y contesta tres preguntas más sobre el nuevo: si seguirá siendo verdad dentro de un mes, si le servirá a otra conversación y si la fuente respalda su porqué.
- Si es el mismo, sus episodios se suman al recuerdo que ya existía.
- Si lo actualiza o lo contradice, el viejo se cierra, pero no se borra: la búsqueda lo recupera cuando la pregunta es por la historia.
- Si no merece la pena, se queda solo en los episodios.
Y si la probabilidad no llega a 0,6, no se fusiona ni se cierra nada: ante la duda, se quedan los dos.
Hubo dos cosas que solo descubrí midiendo.
El vector solo no basta. Para un modelo de embeddings, «el balanceador corta a los 120 s» y «corta a los 600 s» tienen una similitud de 0,947. Usado como juez, el coseno acertaba el 64 % de las relaciones etiquetadas, menos que contestar siempre «son distintos», que acierta el 76 %. Por eso una regla determinista corrige a cualquier juez cuando cambian números con su unidad, versiones, identificadores o negaciones. La primera versión se pasaba de estricta y bloqueaba 32 de 43 duplicados reales; ajustada, deja pasar 7 de las 12 fusiones correctas que proponía el juez, en vez de 4, sin colar ninguna mala.
El juez tiene que ver el trozo que importa. En un episodio largo, como un log pegado o el informe de un subagente, la frase que respalda el porqué suele quedar lejos del principio. Ahora el juez recibe los fragmentos más parecidos al recuerdo, elegidos por embedding, hasta 1.500 caracteres:
Buscar sin llamar a un modelo
Para contestar una pregunta no se llama a ningún modelo de lenguaje. Cada servidor tiene en RAM un índice con todo: un autómata con los nombres y alias de las entidades, bitmaps por entidad y papel, BM25 sobre el qué, el porqué y el cómo, y los vectores cuantizados a int8. El modelo de embeddings, EmbeddingGemma 2 sobre ONNX Runtime, va dentro del propio binario.
La pregunta se analiza con reglas: qué entidades nombra, a qué W se refiere («¿por qué…?») y qué fechas menciona. Cada recuerdo recibe una puntuación determinista, y lo que ya no es verdad queda por detrás de lo vigente, salvo que la pregunta sea por la historia. Una búsqueda tarda 35–50 ms contando el embedding de la pregunta, y con un índice sintético de un millón de recuerdos, solo la ordenación tarda unos 8 ms (p95).
Esto también lo medí. Con 13 preguntas sobre mi propia memoria cuya respuesta conocía, la primera versión ponía el recuerdo correcto en primer lugar solo 4 veces. Tras una mañana de arreglos fueron 9, y 13 de 13 entre los tres primeros. Uno de los fallos: el sistema Nomad y el repo Nomad, dos entidades que se llaman igual, contaban dos veces.
Una memoria que se mide a sí misma
Una memoria que cuesta más de lo que ayuda no merece la pena, así que mnemo lleva la cuenta de las dos cosas.
Lo que añade. Los hooks añaden memoria al abrir la sesión y antes de cada mensaje, con un máximo de 800 tokens por bloque y 4.000 por sesión. No repiten lo que ya se añadió en esa sesión, no añaden lo que salió de la propia sesión (el modelo ya lo tiene delante) y no se disparan con los avisos de tareas en segundo plano, que no son preguntas. En mis últimos 30 días, 563 turnos, todo eso sumó 141.000 tokens: el 0,007 % de lo que leyeron esas sesiones.
Si se usó. Al acabar cada turno, los recuerdos que se añadieron se comparan con la respuesta: si la respuesta los cita, se usaron; si no, el modelo de decisiones da una probabilidad. Un recuerdo que en 30 días sale seis veces como claramente no usado, y ninguna como usado, deja de añadirse para esa persona, aunque una búsqueda explícita lo siga encontrando.
La primera auditoría, a los tres días, fue un jarro de agua fría: de 171 recuerdos añadidos a sesiones y etiquetados a ciegas, solo se habían usado 9. Las causas saltaban a la vista:
- un 35 % llegaba con avisos de tareas en segundo plano;
- la mitad de lo que llegaba con cada mensaje ya estaba en la sesión;
- 135 recuerdos colgaban del repo en el que trabajaba, aunque solo 37 trataban de él, así que todas las sesiones empezaban con los mismos;
- y la destilación me atribuía como decisiones propuestas que había hecho el asistente.
Todo eso está arreglado, y esas mismas etiquetas sirvieron para fijar los umbrales. El modelo de decisiones distinguía bien lo usado de lo no usado (un AUC de 0,94), pero daba probabilidades bajas incluso a lo que sí se había usado, entre 0,036 y 0,384, así que un corte en 0,5 lo habría silenciado todo. Ahora un recuerdo cuenta como usado a partir de 0,08, y para silenciarlo solo cuenta lo que queda por debajo de 0,03, que es lo seguro. Cuánto ha mejorado todo esto lo dirá una nueva ronda de etiquetas a ciegas.
Lo que no funcionó
- El modelo de embeddings como juez: el 64 % que contaba antes.
- Un juez diminuto entrenado con mis datos. Con mis datos ganaba al modelo de decisiones (0,918 frente a 0,872), pero fuera de ellos, en 720 pares sintéticos de seis temas, perdía (0,90–0,91 frente a 0,95), y fallaba justo donde más importa: cuando cambia una cifra o una versión.
- Unos criterios «más claros» para el juez. Reescribí las definiciones de actualizar y contradecir para que fueran más fáciles de seguir, y el acierto bajó de 0,872 a 0,843.
Pruébalo
git clone https://github.com/mariojcr/mnemo.git && cd mnemo
export MNEMO_ADMIN_KEY=$(openssl rand -hex 24)
docker compose up -d
Con eso arrancan mnemo y ClickHouse, y ya puedes guardar y buscar sin ningún modelo de lenguaje. Para destilar conversaciones hace falta un endpoint compatible con OpenAI, como Ollama. Claude Code se conecta con un plugin, que guarda cada turno, recupera contexto antes de cada mensaje y añade las herramientas recall, remember, forget, keep y recall_episode; Codex, con el servidor MCP y sus hooks, y cualquier otro cliente, por MCP o HTTP.
Los episodios y los recuerdos se quedan en tu ClickHouse, y los embeddings se calculan en local; solo sale lo que mandes a los modelos que configures para extraer y juzgar. Cada persona tiene su propia memoria. Eso sí, es software joven: solo hay binarios para Linux x86_64, cada servidor guarda el índice en su RAM y hay un único escritor por base de datos. La versión 0.1.1 ya está publicada, con imagen Docker y binarios firmados.
Lo siguiente es otra ronda de etiquetas a ciegas, y pasar LoCoMo y un escenario escrito por otra persona, para quitarle a la comparativa el sesgo del autor. El código y la documentación están en github.com/mariojcr/mnemo.